В 2026 примерно каждый седьмой использует ИИ для написания текстов, но работать с большими документами – регламентами, ТЗ, положениями, отчётами, длинными инструкциями, пакетами тендерной документации – отдельное искусство, которым пока владеют единицы, и я вас ему научу, потому что без четкого понимания, как делать это правильно, даже самый лучший ИИ не спасёт вас от боли, разочарования и совершенно напрасно убитого времени.
Типичный большой документ – это от 20 до 200 страниц текста со сложным форматированием, оглавлением, таблицами, иллюстрациями, сносками, который нужно собрать либо с нуля, либо из исходников в самых разных форматах – .doc, .docx, .pdf, .rtf или ещё более древних и экзотических.
Я честно, по шагам расскажу вам, с какими проблемами вы столкнётесь в работе с такими документами, откуда они проистекают и как их обойти, чтобы экономить себе от нескольких десятков до нескольких сотен часов на каждом.
Работа с текстами в чатах
LLM блестяще справляются с рутинными операциями над текстом, на которые у живого редактора уходят часы: проверка орфографии и пунктуации, единообразие терминологии, исправление повторов и тавтологий, выравнивание стиля (включая переписывание неудобоваримых абзацев и разбиение стен текста), приведение списков и заголовков к единому формату. Это десятки мелких правок, и модель выполняет их всего за пару минут.
Особенно хорошо нейросети справляются там, где нужно методично применить одно и то же правило ко всему тексту: поменять оформление списков, заменить слово-синоним на канонический термин из глоссария, перевести все даты в единый формат, убрать англицизмы или, наоборот, русифицировать наименования отделов. Всё это монотонная работа, в которой модель не устаёт, не отвлекается и не пропускает сотый пункт.
Полезны LLM и в задачах, требующих внимания к перекрёстным ссылкам: поймать «см. раздел 5.2», который ссылается на уже несуществующий раздел, или заметить, что нумерация пунктов поехала после того, как в середину добавили новый подпункт.
Самый очевидный вариант работы с текстами это, разумеется, чаты, и вариантов тут немного: либо выбираете бесплатную нейросеть (Deepseek или Qwen), либо условно-бесплатную (ChatGPT или Claude) через VPN. Можно ещё попробовать Google Gemini, но она из России в последнее время даже c VPN работает не всегда.
Мы так привыкли к тому, что ИИ играючи справляется с текстами размером в 1-2 странички, что ожидаем от них выдающихся результатов и в работе с по-настоящему большими текстами. Но, увы, мне придётся вас разочаровать: работать в чате с большими документами – это мазохизм, а в бесплатном чате – вообще какое-то дикое извращение, которому нет разумных оправданий.
Да, все четыре упомянутых выше чата могут принимать и распознавать документы Word, причём довольно тяжёлые: 200+ страниц с картинками и общим весом в десятки мегабайт. Однако вывести готовый отредактированный .docx смогут только ChatGPT и Claude. ChatGPT плохо справляется со старым форматом .doc и может выбросить из документа все картинки, а вот Claude молодец – делает всё корректно, да ещё и показывает свои корректировки в тексте в режиме правки.
Бесплатного суточного лимита и в ChatGPT и Claude хватает на 2-3 серьёзных правки документа в 20-30 страниц, после чего они начинают требовать денег. Практически, с помощью бесплатного Claude можно разве что быстро поправить за один проход стилистику и орфографию готового документа, а о каких-либо серьёзных правках можно забыть – всё только за деньги. Но если уж всё равно платить, то не за него, но об этом – позже. Можно, разумеется, сделать 10 разных аккаунтов и перетаскивать документ между ними, но для серьёзной работы этот геморрой не стоит свеч.
Deepseek и Qwen не ограничивают вас в количестве правок, но результат выдают не готовым файлом для скачивания, а текстом в окне, который нужно скопировать/вставить в готовый документ. Без картинок, разумеется. Если будете копировать текст прямо из чата, то все стили и шрифты нужно будет править руками в Word.
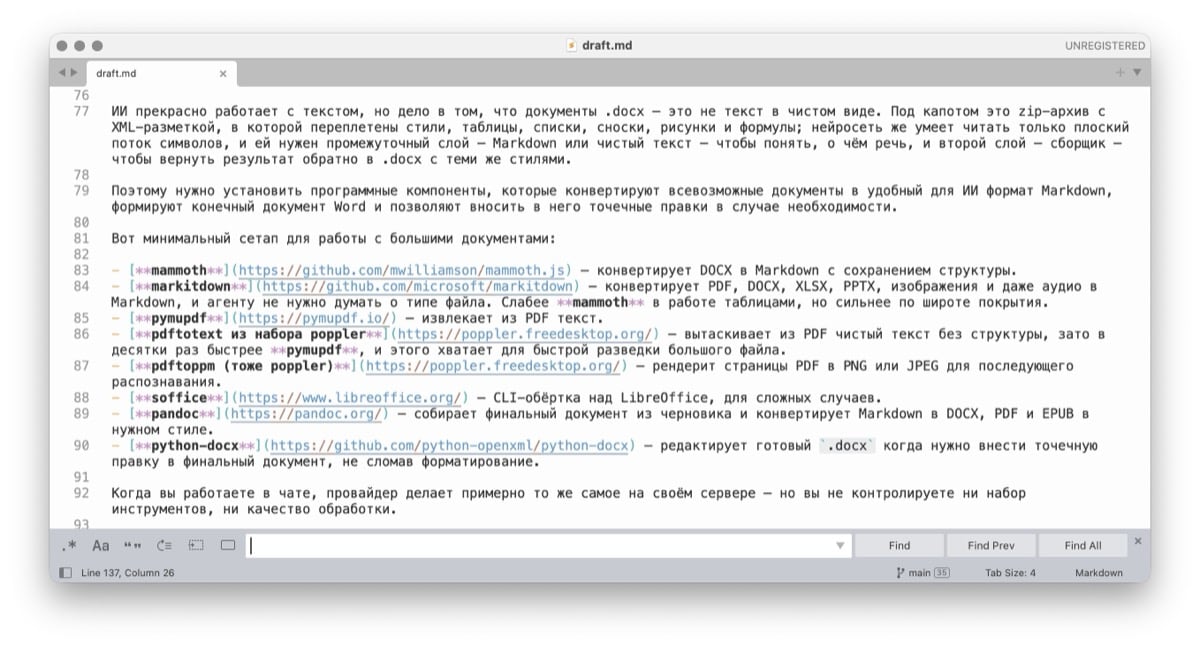
Чуть более продвинутый вариант при работе с ними – попросить ИИ генерировать текст в формате Markdown, а затем отрывать его в отдельном редакторе и экспортировать в Word — так, по крайней мере, стили заголовков и текста будут везде одинаковыми и их будет относительно легко переназначить: редактируем текст, копируем, вставляем, экспортируем, меняем стили, вставляем на место картинки/схемы, а потом выясняется, что нужно сделать ещё несколько правок и всё придётся повторить с самого начала. Звучит не слишком приятно, но и это ещё не всё.
Многие слышали про «контекстное окно» моделей и оно сейчас огромное – до миллиона токенов. Вроде бы как должно хватать с избытком для любого текста, но на деле работают другие важные ограничения, причём как у бесплатных моделей, так и у платных.
| Модель | Макс.ответ | Макс.текст |
|---|---|---|
| DeepSeek V4.1-Flash (бесплатно) | 384K токенов | ~240 страниц |
| Qwen 3.8-Max (бесплатно) | 131K токенов | ~80 страниц |
| ChatGPT Free — GPT-5.6 Luna (бесплатно) | 128K токенов | ~80 страниц |
| Claude Sonnet 5 (бесплатно) | 128K токенов | ~80 страниц |
Максимальный размер вывода у большинства моделей в разы меньше контекстного окна, к тому же из этого значения нужно вычесть токены, потраченные моделью на размышления и вызов инструментов в процессе обработки текста. Если очень грубо пересчитать оставшиеся токены в русский текст, то получится, что большинство доступных сейчас моделей физически не способны выдать за один приём документ больше 80 страниц объёмом (по факту – меньше), а я в своей практике видел отчёты и потолще.
Это фундаментальное ограничение модели, и в платной версии оно не решается, поэтому с большими документами в чате реально работать только по частям – главами или разделами. Когда нужна сквозная правка или поиск дублей/противоречий/не стыковок по всему тексту, чат может выдавать фрагменты с точечными правками, которые придётся ставить на место вручную.
Мало того, после этих правок нужно будет загрузить весь исправленный документ обратно в чат, чтобы ИИ видел, что реально изменилось и мог двигаться дальше. Каждая такая загрузка быстро сжирает контекст: пять раз загрузил документ на 100 страниц – и больше половины контекста занято, модель снижает качество выдачи, начинает хуже исполнять инструкции, ощутимо «тупеет» – нужно начинать новый чат и просить модель сделать handoff – заметки о том, что и как уже сделано и что нужно будет делать дальше, чтобы работа не пошла по кругу.
Каждый раз, когда модель выдаёт новые правки, нужно вручную сохранить резервную копию текущей версии документа (желательно с человекопонятным номером версии). Это сильно замедляет работу и у любого нормального человека рано или поздно появляется соблазн делать копии только после больших правок, экономя время. Постепенно промежутки между копиями становятся всё больше (модель обычно работает хорошо), и в конце концов, когда она даёт сбой вы с ужасом обнаруживаете, что половина документа куда-то делась и надо откатываться на 2-3 часа назад. Очень неприятно, знаю по собственному опыту.
И кстати: бюджетом размышлений модели тоже нужно пользоваться разумно. Когда вы просите модель переработать сразу весь документ или внести несколько содержательных правок плюс проверить орфографию одним промптом, она делит бюджет размышлений на все эти задачи по чуть-чуть и качество реализации каждой из них заметно проседает. Поэтому только одна задача или один тип правок за раз, только на один раздел, и лишь потом следующая задача. И вы должны всё время держать в голове, что осталось сделать.
В общем, ИИ чаты – это сомнительное удовольствие при работе с текстами. Если бы меня всё же заставили работать с большими текстами только в них, я бы пожалуй, выбрал Claude за $20, потому что все остальные бесплатные варианты будут ещё хуже. Но раз уж всё равно придётся платить, есть ли способ потратить деньги лучше? Разумеется, и сейчас я об этом расскажу.
Подготовка агента к работе
Вся мощь современного ИИ для документов раскрывается тогда, когда он работает в связке с агентом. И это – блестящее подтверждение тезиса «порядок бьёт класс», потому что даже недорогая модель, снабжённая эффективными инструментами и работающая по разумно выстроенной процедуре даёт гораздо лучшие результаты, чем топовая модель, предоставленная сама себе.

Если вы не знаете про AI-агентов, то вкратце это программа-посредник между вами и нейросетью, которая работает на вашем компьютере и умеет сама вызывать инструменты: читать файлы, запускать команды, искать в интернете, ходить в базы данных. В отличие от чата, агент может разбить большую задачу на шаги, проверить промежуточный результат, вернуться назад и переделать, если что-то пошло не так, и собрать всё в готовый документ без вашего участия на каждом шаге.
Сейчас своих агентов выпускают все компании, занимающиеся AI, и вообще все, кому не лень, но есть два наиболее универсальных, гибких и быстро развивающихся – Hermes и OpenClaw. Я лично предпочитаю Hermes – он, на мой взгляд, лучше подходит для ситуаций, когда постоянно надо делать что–то новое (его фишка – самообучение) и к тому же он несколько стабильнее OpenClaw. Оба этих агента могут работать с любыми моделями без ограничений.
И да – агенту нужен доступ к модели по API, сам по себе он не работает. Какой ИИ лучше подходит для ваших задач, зависит от того, насколько часто и много вы планируете работать. Если нужно делать что-то с помощью агента экономно и время от времени, то хороший вариант это Deepseek – вы платите только за реально потраченные токены (вход и выход модели), без подписки и абонентской платы. Если работа постоянная и её много, то лучше подписка на Minimax с фиксированной месячной оплатой и большим запасом токенов. А если хочется поэкспериментировать с разными моделями и сравнить – то OpenRouter с кучей разных моделей на выбор (в том числе – топовых) и тоже оплатой за токены.
Оплатить зарубежные сервисы из России не проблема, есть куча сервисов, например – https://oplatym.ru. Комиссия у него довольно большая, но работают они быстро, четко, без сбоев.
В общем, регистрируетесь, получаете API-ключ, устанавливаете агента, скармливаете ему этот ключ во время установки и, если вы это сделали, считайте, что самое сложное позади – всё остальное агент поможет сделать вам сам. В том числе – скачать и установить все необходимые программные компоненты (в конце статьи будет ссылка на skill, который всё это сделает).
Ключевые компоненты
Самая важная вещь при работе с большими документами – взять под контроль изменения: сделать их небольшими, отслеживаемыми, с возможностью отката в любой момент, чтобы не выходить за пределы окна вывода, не забивать контекст модели и минимизировать последствия ошибок.
И для этого есть прекрасный инструмент – git. Появился он задолго до самих нейросетей: в 2005 году его написал Линус Торвальдс, чтобы навести порядок в разработке ядра Linux, где сотни разработчиков по всему миру одновременно правят одни и те же файлы. С тех пор git де-факто стал стандартом управления изменениями в любом проекте сложнее школьного сочинения, и в работе с большими документами через агента он делает ровно то, для чего создавался: превращает каждую правку в отменяемое действие (любую можно откатить одним шагом назад, к любому моменту работы), фиксирует историю решений между сессиями (когда через неделю модель уже не помнит, почему был сделан тот или иной выбор), позволяет безопасно экспериментировать (агент пробует разные варианты правок, вы оставляете лучший), разрешает параллельную работу нескольких человек и нескольких агентов над одним документом без конфликтов: каждый работает в своей ветке, потом вы просто выбираете, какие правки брать. Без git агент и человек работают в режиме, где каждая ошибка необратима.
ИИ прекрасно работает с текстом, но дело в том, что документы .docx – это не текст в чистом виде. Под капотом это zip-архив с XML-разметкой, в которой переплетены стили, таблицы, списки, сноски, рисунки и формулы; нейросеть же умеет читать только плоский поток символов, и ей нужен промежуточный слой – Markdown или чистый текст – чтобы понять, о чём речь, и второй слой – сборщик – чтобы вернуть результат обратно в .docx с теми же стилями.
Поэтому нужно установить программные компоненты, которые конвертируют всевозможные документы в удобный для ИИ формат Markdown, формируют конечный документ Word и позволяют вносить в него точечные правки в случае необходимости.
Вот минимальный сетап для работы с большими документами:
- mammoth – конвертирует DOCX в Markdown с сохранением структуры.
- markitdown – конвертирует PDF, DOCX, XLSX, PPTX, изображения и даже аудио в Markdown, и агенту не нужно думать о типе файла. Слабее mammoth в работе таблицами, но сильнее по широте покрытия.
- pymupdf – извлекает из PDF текст.
- pdftotext из набора poppler – вытаскивает из PDF чистый текст без структуры, зато в десятки раз быстрее pymupdf, и этого хватает для быстрой разведки большого файла.
- pdftoppm (тоже poppler) – рендерит страницы PDF в PNG или JPEG для последующего распознавания.
- soffice – CLI-обёртка над LibreOffice, для сложных случаев.
- pandoc – собирает финальный документ из черновика и конвертирует Markdown в DOCX, PDF и EPUB в нужном стиле.
- python-docx – редактирует готовый
.docxкогда нужно внести точечную правку в финальный документ, не сломав форматирование.
Когда вы работаете в чате, провайдер делает примерно то же самое на своём сервере — но вы не контролируете ни набор инструментов, ни качество обработки.
Регламенты, ТЗ и отчёты почти всегда требуют схем процессов, диаграмм последовательностей и графиков. Здесь помогает mermaid – открытый движок, который рисует диаграммы из текста на простом псевдо-языке. Полезные для документов типы: блок-схемы (flowchart) для процессов и регламентов, диаграммы последовательностей (sequence diagram) для потоков взаимодействия в ТЗ, диаграммы Ганта (gantt) для планов работ, диаграммы классов и сущностей (class diagram и ER diagram) для связей между объектами, интеллект-карты (mindmap) для оглавления большого документа, ленты времени (timeline) для истории изменений.
Дополнительные компоненты
Дополнительно можно поставить ещё несколько компонентов: работать с агентом можно и без них, но качество документа со временем начнёт уплывать, потому что вики и линтер ловят те мелочи, которые человек от частого повторения перестаёт замечать.
- llm-wiki – локальная вики-база с быстрым поиском по проекту, в которую агенту удобно складывать сущности документа: термины глоссария, имена отделов, номера регламентов, упоминания конкретных продуктов. Когда агенту нужно найти каноническое название процедуры согласования договоров, он идёт в вики и достаёт готовый ответ за секунду, а не перечитывает весь документ заново и не выдумывает формулировку и тогда по всему тексту «договор» не превращается внезапно в «соглашение» или «контракт», а «заявитель» остаётся «заявителем» от первой страницы до последней.
- markdownlint-cli2 – линтер для Markdown, который проверяет единообразие оформления по всему проекту: чтобы заголовки шли по уровням без пропусков, чтобы списки были одного стиля (тире или звёздочка, а не мешанина), чтобы вокруг блоков кода стояли пустые строки, чтобы длина строк не выходила за разумный предел. Сам по себе он ничего не правит – только подсвечивает нарушения правил и ссылается на конкретную строку файла. На длинном документе стилистические мелочи накапливаются незаметно: на третьей главе появился заголовок H4 без родительского H3, на пятой — список через точки вместо тире, на восьмой — лишний пробел перед точкой. Без линтера автор это увидит только при финальной вычитке, когда править уже поздно и дорого; с линтером агент получит список замечаний сразу после каждой правки и держит документ в одной стилистике от начала до конца без ручного контроля.
Компоненты для поиска и извлечения информации
Для работы с открытыми источниками данных – на случай, если в текст нужно будет найти и вставить ссылку на статью, ГОСТ или пункт ведомственного постановления агенту понадобятся инструменты для поиска и извлечения информации. Их существует много, есть бесплатные и платные варианты – выбирайте по объёму работы и требованиям к качеству.
Без VPN из России:
- ddgs — метапоисковая библиотека от deedy5 с бэкендами DuckDuckGo/Bing/Brave/Яндекс и др. (по умолчанию DuckDuckGo), есть CLI и MCP-сервер; для большинства рутинных запросов выдача заметно шумнее, чем у специализированных поисков, но зато работает без ключей и из России без VPN.
- Яндекс Search API через Yandex Cloud — от 30,5 ₽ за 1 000 отложенных запросов (~3 копейки за запрос, для разовых правок документа это копейки) до 488 ₽ за 1 000 синхронных.
- Jina Reader — извлечение из страницы сайта чистого markdown с отрезанной навигацией и рекламой, бесплатно без ключа, но с жёсткими rate limits; для больших объёмов нужен API-ключ.
Под VPN:
- Tavily — 1 000 API-кредитов в месяц бесплатно, без кредитной карты; платные альтернативы Tavily Extract нужны редко – в основном когда нужна очень точная структура страницы или таблицы, и тогда разница в качестве окупается только на больших объёмах.
- Exa — $20 кредитов при регистрации плюс $10 каждый месяц на Free Tier (это суммарно $120+ в год без оплаты), нейронный ранкер, силён на многошаговых запросах и поиске по GitHub-докам.
- Serper — сырой Google SERP по 2 500 запросам за $1 в первый месяц trial, потом $375/мес за 500k кредитов.
Если вы всё это установили – поздравляю, теперь в ваших руках мощный комбайн, готовый работать с текстами любого разумного размера с максимально возможным сейчас качеством. Пора приступать к работе.
Работа с текстом в агенте
Любая нейросеть для генерации текста выдаёт качественные документы, если работает по четкой последовательно процедуре, задающей ИИ рамки, и это справдливо как для агентов, так и для ИИ в чате.
Первое и самое очевидное – необходимо создать детализированную структуру документа с основными разделами и кратким описанием того, что должно быть в каждом из них. Это позволит ИИ работать с отдельными частями документа, а потом собрать его в один большой файл с минимумом дублирования. Такая процедура экономит в процессе работы токены и повышает качество генерируемого текста.
Второе — это стиль-гайд. Отдельный документ, который описывает уже не содержание, а форму текста: от чьего лица, в каком стиле, для какой аудитории, в каком времени, с какими обязательными элементами оформления должен быть текст. Это обеспечивает единообразие стиля отдельных частей и, что важно, использование специфической для предметной области терминологии с нужной глубиной.
Для работы с документом нужно создать отдельную папку, в которой будут лежать эти файлы, черновики разделов и сырьё – все исходные документы и таблицы с данными, а также информация, собранная из открытых источников.
Затем нужно создать git-репозиторий папки с помощью агента и можно приступать непосредственно к работе над текстом.
Дальнейшая работа – это ряд последовательных итераций над каждым из разделов:
-
Создание черновика — на основе сырья, структуры и стиль-гайда ИИ пишет первую версию текста (обычно – очень сырую, но это нормально).
-
Проход редактора – проверяется структура, логика и композиция текста. Редактор смотрит, всё ли сказано, в правильном ли порядке, нет ли дыр в аргументации и не провисает ли нарратив. Не трогает стиль, не вылавливает опечатки и не переписывает абзацы – только отмечает, что стоит перестроить, добавить или убрать.
-
Проход альфа-ридера – ИИ анализирует документ как читатель-первопроходец, который впервые видит текст. Отмечает места, где он спотыкается, не понимает термин, теряет нить или чувствует, что раздел скучный. Этот проход самый важный для читаемости: именно здесь выясняется, понятен ли текст человеку со стороны.
-
Проход локализатора, если в исходном тексте много иностранных терминов – на этом этапе происходит перевод, адаптация и уточнение терминологии. Локализатор смотрит, где иностранное слово можно заменить русским эквивалентом, где нужно дать расшифровку при первом упоминании, и где оставить оригинал как устоявшийся термин. Запускается только для текстов с заметной долей иностранных терминов; для русского блога чаще всего не нужен.
-
Проход корректора – проверяется стиль, плотность и читаемость текста. Корректор вылавливает тавтологии, канцелярит, слабые глаголы, раздутые конструкции и расхождения стиля между разделами.
-
Проход орфографа – исправляется орфография, пунктуация и типографика. Этот проход опциональный: он запускается, только если корректор нашёл больше двух чисто-орфографических замечаний – это сигнал, что объём правок оправдывает отдельный проход.
Первые черновики разделов лучше создать последовательно, один за другим, чтобы в них был минимум пересечений и дублей, а потом можно запустить несколько параллельных агентов для их доводки.
Каждый проход должен не править текст самостоятельно, а оставлять список замечаний, которые вы можете принять или отклонить перед переходом к следующему этапу. Если вы видите слишком много неадекватных замечаний, нужно скорректировать стиль-гайд, чтобы ИИ лучше понимал, в каком направлении двигаться. Разумеется, можно тупо скомандовать агенту «отработай все замечания», но это прямой путь к получению дичайшего нейрослопа, а нам такое не нужно.
Очень важно соблюдать правильную иерархию проходов: от общего к частному. Сначала работа со структурой, потом общий стиль, и только потом орфография. Нет никакого смысла править орфографию в абзаце, который потом будет выброшен в процессе правок или полностью переработан.
После каждого прохода я читаю текст сам и оставляю прямо в нём комментарии-инструкции, которые агент должен отработать во время следующего прохода. Комментарии я помечаю косыми чертами: ‘//вставь ссылку на нормативный акт//’, ‘//сократи раздел//’, ‘//актуализируй данные в таблице//’ и так далее.
Когда приступаете к проходам по тексту, начните с установки среднего уровня размышлений модели и посмотрите на результат. Если получилось плохо – сначала попробуйте доработать промпт. Если не помогло – поднимайте уровень размышлений до высокого. Потом снова пробуйте править промпт. Двигайтесь такими итерациями, не стоит сразу выставлять максимально высокий уровень размышлений, иначе можете очень быстро упереться в лимиты использования модели.
Когда каждый из отдельных фрагментов текста доведен до приличного состояния, можно приступить к самой затратной с точки зрения расхода токенов задаче – сквозным правкам. На этом этапе проверяется структура всего текста целиком на дублирования и нестыковки между разделами, единообразие сквозного глоссария, тона, стиля, нумерации и так далее. Это можно увидеть, только загрузив в LLM весь текст сразу (не важно одним файлом или несколькими).
Единственный ограничитель здесь – эффективный размер контекстного окна. «Эффективный» значит тот, при котором модель не путается в показаниях. У слабых моделей он может составлять примерно 50% от заявленного максимума, хорошие работают даже загрузившись под завязку. Теоретический максимум для модели с контекстом 1М это примерно 416–833 страницы (от ~416 для слабых моделей до ~833 для сильных, ~666 — практичный рабочий размер). Если нужно работать с текстом большего размера, то придётся организовать промежуточный слой – детализированное содержание, список концептов, глоссарий, цепочку аргументации и т.д. Это не сложная задача, но для каждого типа текстов решается чуть-чуть иначе.
И вот когда этот этап пройден, можно переходить к конвертации текста в финальные форматы – .docx, .pdf, .epub. Задача сугубо техническая: задаёте агенту список требований к оформлению, шрифтам, полям, размерам, он делает первый вариант (разумеется, с недочётами), вы делаете замечания и через пару тройку итераций получаете приемлемый результат. Эту схему экспорта нужно зафиксировать на будущее, и всё. На этом работа непосредственно с текстом завершена.
Всю это процедуру (вместе с инструкцией для агента по установке компонент) я собрал в skill — переиспользуемый навык для агента, который вы сможете скачать и пользоваться. Это облегченная версия того, что я использую в работе сам. Облегчённая не потому, что мне жалко делиться полной версией, а потому что моя система навыков с документами глубоко оптимизирована под мой софт, мои специфические задачи и стиль работы – исследования, статьи, книги, работу с блогом, описание и оптимизацию бизнес-процессов. В ней – 9 основных навыков и ещё парочка вспомогательных и это – как костюм, сшитый по мерке: мне подходит, а другим придётся перешивать его под себя.
Оптимизация работы с большими документами
Даже если вам нужно делать всего один большой документ в год, не рассматривайте ИИ чаты как хороший вариант. Чат – это просто демо-версия, обеспечивающая новичкам легкий вход в тему ИИ. Платный чат – демо-версия + тест на готовность платить, не более того. Нормальный рабочий процесс для профессионала сейчас – это обязательно агентная система. А стандартизированный массовый рабочий процесс – это оптимизированная под конкретный класс задач агентная система.
У этой оптимизации есть как минимум четыре очевидных вектора: выбор провайдера модели или локальной модели, подходящей для текущих задач; подбор оптимальных инструментов для агента (для поиска и хранения данных, импорта/экспорта документов и т.д.); оптимизация промптов и навыков (skills) агентной системы; а так же – оптимизация навыков тех людей, кто с этой системой работает (их обучение).
Выбор модели зависит от того, насколько «художественным» должен быть текст. Чем выше требования к литературному стилю, тем более мощная модель обычно требуется. В каждом конкретном случае лучше начать с доступных середнячков, поэкспериментировать и сравнить их результаты с топовыми моделями. В общем случае локальные модели слабее доступных облачных и ставить их имеет смысл только их использование обосновано соображениями секретности или требованиями ФЗ-152 «О персональных данных». Лично мне вполне хватает текущего уровня китайских моделей (я пользуюсь MiniMax M3).
Инструменты для агента определяются в основном входными данными – нужно ли распознавать PDF с текстом в виде картинок и с каким количеством вводных данных придётся работать. Если речь идет не о сотнях документов, а о тысячах, имеет смысл дополнительно подумать о базе данных и векторном поиске.
Эффективность промптов и навыков может сильно различаться от модели к модели. Чем тупее модель, тем с одной стороны более подробные инструкции ей нужны, но, с другой стороны, чем больше по размеру инструкция, тем сложнее ей следовать. В результате оптимальный размер инструкции для каждой модели свой и нужно его подбирать экспериментально, начиная с минимального и постепенно наращивая сложность.
Люди – самое узкое место системы. Средний взрослый читает нон-фикшен со скоростью около 240 слов в минуту (мета-анализ 190 исследований, 18 573 участников, Brysbaert 2019), типичная облачная LLM выдаёт 60–110 токенов в секунду, лёгкие модели – 150–240 токенов (benchlm.ai). Поскольку в русском тексте одно слово – это примерно 1.3 токена, разрыв составляет 10–30 раз в пользу модели. По нормам опытного корректора в издательстве, один человек вычитывает ~200 000 знаков в день, или около 110 листов A4 – вот и думайте.
Кардинально повысить скорость чтения нам вряд ли удастся, поэтому сэкономить время можно только на непроизводительных потерях – учиться работать с агентными системами, получая приемлемый результат за меньшее число итераций. И вот тут есть один неочевидный момент: для того, чтобы не просто механически взаимодействовать с системой, как с чёрным ящиком – что-то засунул в него с одной стороны, что-то вылезло с другой – а уметь решать возникающие проблемы и оптимизировать процесс по стоимости / качеству / скорости, нужно понимать азы: как работает токенизатор LLM, что агент грузит в контекст, как кэшируется и сколько стоит вход / выход модели, как снизить количество галлюцинаций, где задачу лучше решить детерминированным скриптом, а где – LLM, что такое MCP-сервер и как его создать, если нужно, какие процессы можно отдать ИИ, а какие – ни в коем случае.
Именно поэтому я рассказываю об этих вещах на своих тренингах по AI и в своей книге. Базовая AI-грамотность для решения практических задач такого уровня это насущная необходимость, поэтому учитесь сами и учите своих сотрудников всеми доступными способами.
С чего начать
Согласно последней доступной статистике, только 3% взрослых работоспособных людей пользуются платными ИИ-сервисами, и это прискорбно: если учитывать стоимость времени, то выяснится, что бесплатный сыр в большинстве реальных рабочих процессов обходится слишком дорого. Я подозреваю, что в большинстве случаев дело не в цене – $20 это не деньги. Людей отпугивает непонимание зачем это вообще и ещё – сложность: модели — агенты — компоненты – промпты – навыки и т.д. Звучит страшно.
На деле всё куда проще. Своими руками вам нужно сделать всего несколько вещей:
- зарегистрироваться на сайте провайдера ИИ,
- заплатить за модель,
- скачать агента,
- скачать и скормить агенту мой skill, который поможет установить все необходимые компоненты и содержит процедуры работы с большими документами.
Ну ладно, ещё можете книжку мою купить, вам будет полезно, а мне – приятно.
Вот и всё. Использовать ИИ для написания текстов можно и нужно, если делать это правильно.
Друзья, подписывайтесь на мой Твиттер (там я пишу чаще) и Телеграм, чтобы получать анонсы новых материалов.



Комментариев: 0