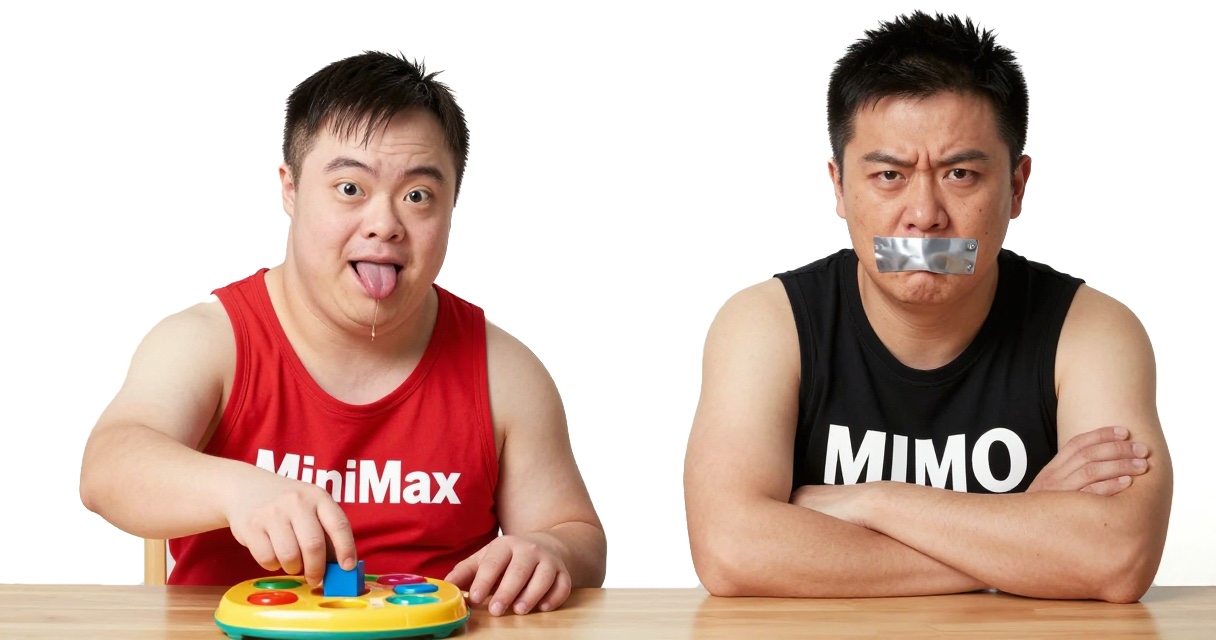
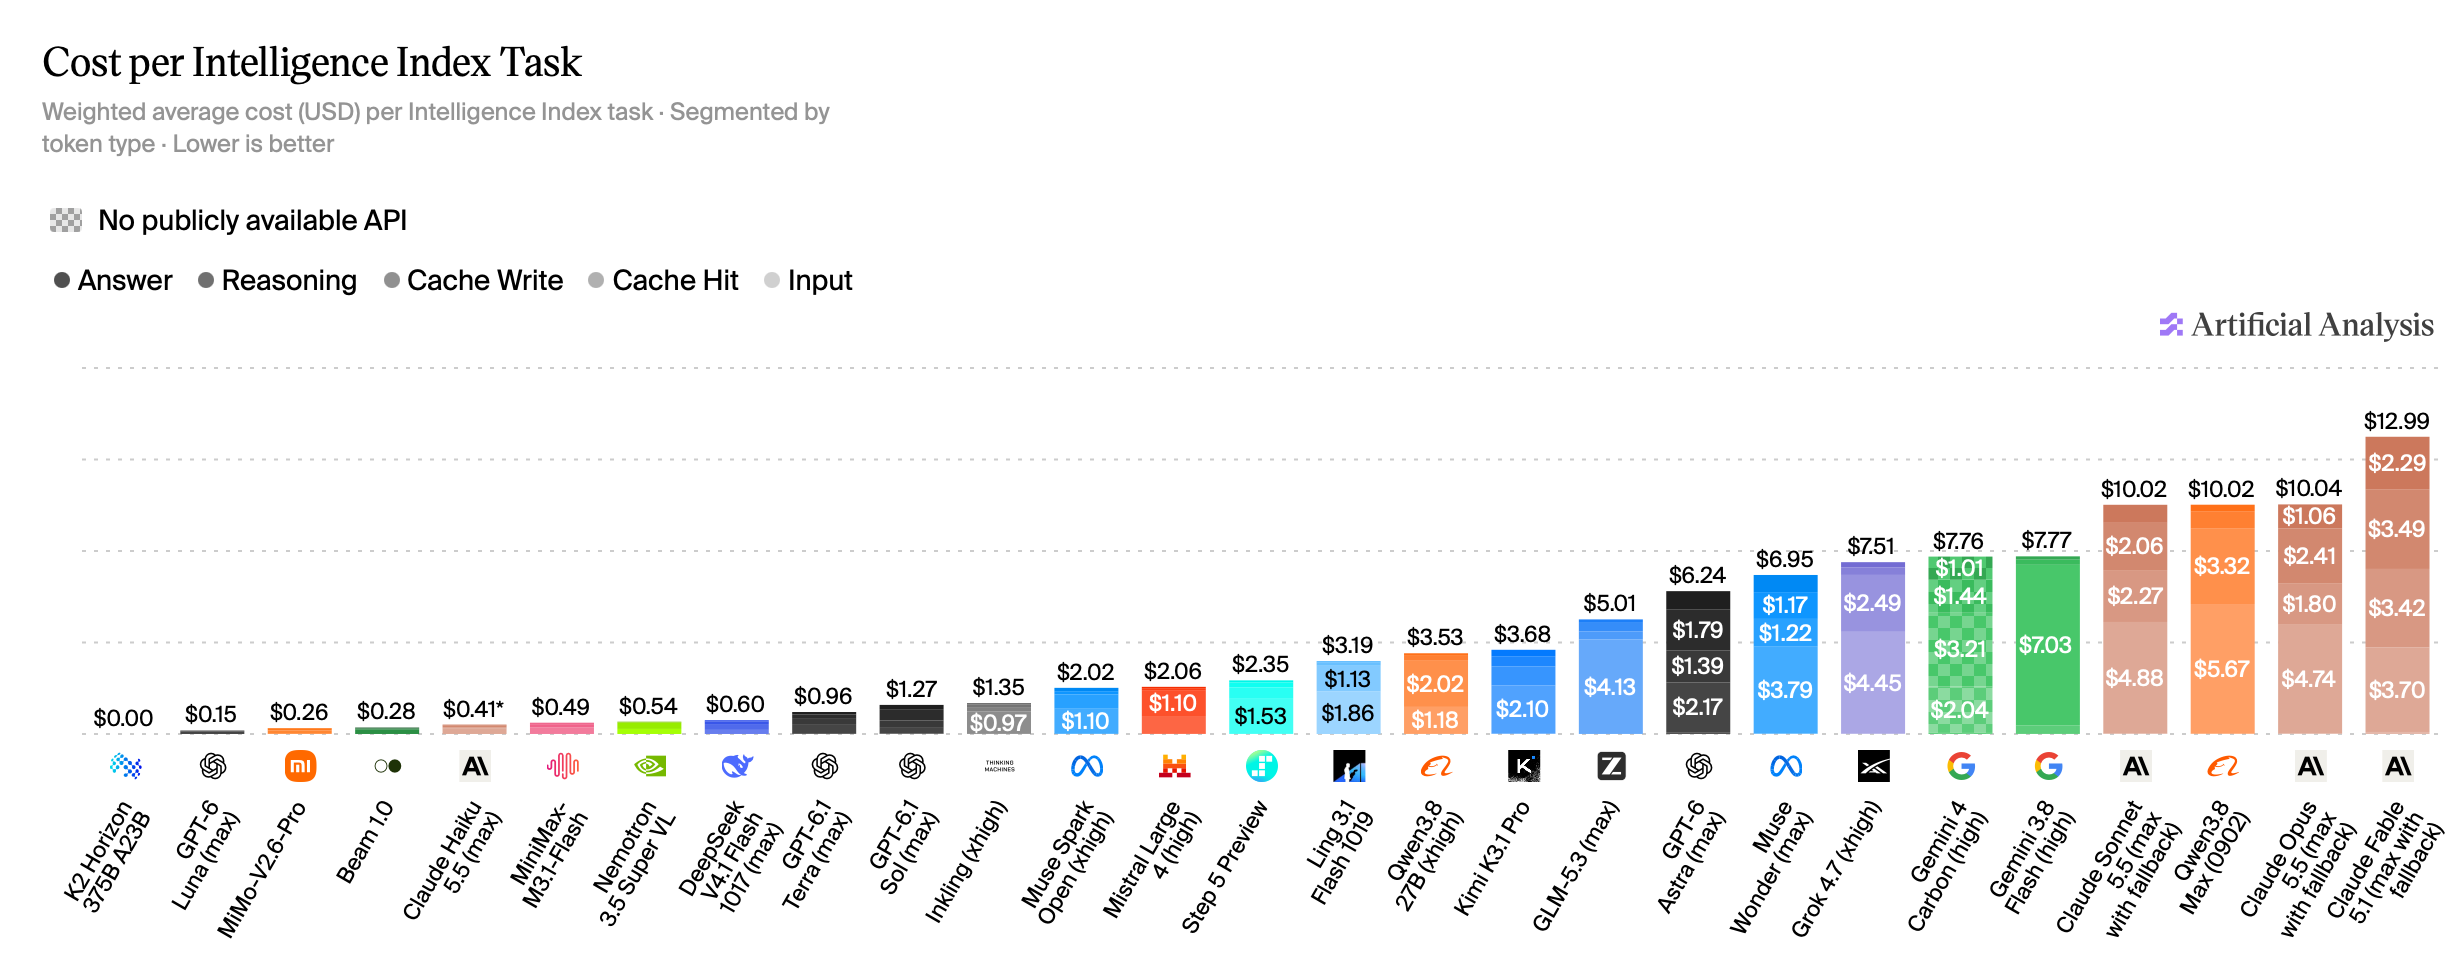
Я сжигаю в месяц примерно 5,4 миллиарда токенов через агентские сессии: на код, тексты, аналитику, подготовку учебных материалов для семинаров, работу с блогом и кучу других задач. ИИ для меня – рабочий инструмент, за который я плачу деньги, и поэтому хорошо понимаю, что сейчас для реальной работы на первый план выходит не интеллект модели, а стоимость выполнения ей ваших задач – сколько денег, токенов и вашего времени съедает одна единица полезной работы.
Рынок LLM чувствует этот запрос и поэтому едва ли не каждую неделю появляется какая-нибудь новая модель с выдающимся соотношением цены/качества. Тем более что топ моделей по интеллекту держат OpenAI, Anthropic и Google, и для китайских вендоров низкая цена задачи – едва ли не единственная возможность конкурировать с ними.
Я эксперимента ради протестировал две модели с многообещающими показателями стоимости задачи – MiniMax M3.1 Flash и MiMo V2.6 Pro – на своих кейсах. И.. Обе модели меня ужасно разочаровали, хоть и каждая по-своему.
MiniMax M3.1 Flash: чистый бенчмаксинг
MiniMax M3.1 Flash вышла 19 октября и обещала всё сразу: индекс интеллекта выше предшественника, цены вдвое ниже, чем у M3, $0,15 за миллион входных токенов и $0,60 за миллион выходных, «200+ токенов в секунду» и «в три раза быстрее M3».
Реальная скорость в моих замерах, кстати, составила свего 43–56 токенов в секунду (не впечатляет), – но это оказалась мелочью на фоне остального.
По факту эта модель – жертва бенчмаксинга в чистом виде. Цифры в бенчмарках высокие, на тестах модель выглядит солидно – но стоит дать ей сложную рабочую задачу, и она пасует. На некоторых задачах модель делала двести шагов, пожирала горы токенов, работая часами и.. не выдавала результата. Вообще.
Хуже всего, что ради бенчмарков она настроена так, что верит в себя и не останавливается, даже если не может дать корректный ответ. В результате, когда ответа нет, она его придумывает – и придумывает уверенно, то есть галлюцинирует. По частоте галлюцинаций она стала сильно хуже предыдущей версии MiniMax M3 и в принципе входит в топ моделей с глюками – за ней нужен глаз да глаз.
С русским языком у неё всё тоже плохо (на порядок хуже GLM. Тестовую задачу по написанию стихов она с треском провалила, как ни старалась – структуры русского языка она чувствует отвратительно, текст выдаёт сухой, куцый, с рублёными неполными предложениями и кальками с английского даже в режиме max reasoning. Это проблема датасета, на котором она обучена, и тут уже ничего не исправить.
Во время работы модель тратит на размышление горы токенов, пытается собрать в контекст много лишней информации, даже если это прямо запрещено, делает много ходов – пытается количеством компенсировать низкое качество и в результате работает над простыми задачами очень долго. По подписке Minimax даже на дешёвых тарифах даёт огромные лимиты, которые очень сложно выбрать, но работать с тупой и болтливой моделью – просто мучение.
Для сравнения я задал MiniMax и MiMo один и тот же тестовый вопрос: «У меня есть кружка. дно отрезано, а верх – запаян наглухо. как из неё пить?».
- MiMo-v2.6-pro выдал ответ за 16,2 с., потратив на него 112 токенов в видимом ответе + 177 на размышления.
- MiniMax-M3.1-Flash ответил за 40,8 с., выдав 398 видимых токенов и израсходовав на размышления 2519 токенов даже не в самом сильном режиме.
С такими характеристиками это, во-первых, не «flash», а слоупок, и, во-вторых, иначе как по подписке с при такой прожорливости с такой моделью лучше дел не иметь.
Судя по всему, этой болезнью страдает не только MiniMax – ту же картину я вижу у многих flash-моделей. Они обещают «почти такой же интеллект», как топовые модели, только в разы дешевле, но по факту этого нет и близко: многословные и многоходовые рассуждения, забивающие контекст, частые галлюцинации, примитивные языковые структуры, ограниченные интеллектуальные возможности делают их пригодными только для примитивных массовых, повторяющихся и верифицируемых задач. Для чего-то мало-мальски интеллектуального я точно предпочту более серьёзные и дорогие модели.
MiMo V2.6 Pro: перебор с цензурой
MiMo V2.6 Pro поначалу произвела на меня хорошее впечатление. Интеллект у неё неплох: в предыдущей версии она даже немного обходила мою любимицу GLM (в актуальной откатилась чуть назад). Модель довольно медленная, но недорогая: даже по API она выходит в $0,13 за задачу против $2,01 у сопоставимого по интеллекту GLM-5.3, в 15,5 раза дешевле по API и раза в три – по подписке.
Модель гораздо лучше работает с русским языком, чем Minimax, хотя и заметно хуже GLM. Очень достойно кодит, не слишком болтлива и, в целом, это была бы хорошая рабочая модель – если бы не её запредельно навязчивая цензура.
До сих пор я считал чемпионами по цензуре модели от OpenAI, но Xiaomi каким-то образом переплюнули даже их. Чуть что – и модель вырубалась с сообщением «The request was rejected because it was considered high risk».
И я бы ещё понял, если бы мы обсуждали тонкости изготовления мефедрона или как лучше взорвать Белый дом, но нет! Она вылетала на совершенно тривиальных задачах:
- рефакторинг навыка генерации изображений – видимо, модель увидела в списке LoRA для нецензурированных изображений и упала в обморок;
- поиск информации о том, взламывался ли Starlink украинской стороной, – тема, которую я разбирал в блоге, – отказ, сочла меня злым хакером;
- сбор информации о среднем уровне зарплат по одной конкретной должности в Санкт-Петербурге – вот тут у меня нет даже идей о том, что её стригерило;
- генерация промпта для картинки про погромы во Франции – отказ в лучших традициях левацкого ChatGPT;
- вопрос об оптимизации скорости загрузки скриптов в моём блоге – отказ на самой тривиальной веб-задаче, тоже без понятия, почему.
Модель просто прерывает агентский цикл в самый неожиданный момент на тривиальной задаче – и ты не узнаешь об этом, пока не заглянешь в окно задачи, ожидая увидеть готовый результат. Со скрытой цензурой в соцсетях я сталкиваюсь постоянно и писал об этом недавно, но цензура, которая останавливает рабочий процесс посреди рефакторинга кода, – это уже за гранью добра и зла.
Кстати, на рефакторинге кода эта модель начала истерику: впала в бесконечный цикл, повторяя «ХМ!», по кругу, пока агент её не прервал. Задачу едва удалось завершить, потому что забитый её «ХМ!» контекст снова и снова провоцировал истерику.
В общем, это явно не та модель, на которую я могу положиться и, тем более, использовать для работы с острыми социально-политическими текстами – это для неё практически табу. Максимум – держать как дешёвый и всегда находящийся под рукой fallback, если лимит GLM по подписке будет неожиданно исчерпан.
Дёшево и качественно
В итоге ни одну из этих двух моделей я не могу рекомендовать для постоянной работы. MiniMax M3.1 Flash превращает любую сложную задачу в многочасовой забег с сомнительным результатом, а MiMo V2.6 Pro упирается в стену там, где работа даже не пахнет чем-то запретным, и останавливается в момент, который невозможно предугадать.
Остаётся отдавать дешёвым моделям только самые простые, рутинные, массовые задачи, где результат проверяется механически, а ошибка стоит дёшево, но в моей работе таких задач, к сожалению, мало: почти всё штучное и интеллектуальное.
Так что дёшевый и качественный инферес у китайцев пока не задался, несмотря на все уверения вендоров и отличные бенчмарки. Чего, собственно, и следовало ожидать.
Друзья, подписывайтесь на мой Твиттер (там я пишу чаще) и Телеграм, чтобы получать анонсы новых материалов.

Комментариев: 0