В последних постах я разбирал, как ИИ справляется с русским текстом: писал стихи и разбирался с большими документами – и оба раза судил о качестве по собственному впечатлению, а его легко упрекнуть в субъективности. Теперь появился повод перевести разговор в цифры: разработчик открытого конвейера перевода книг BookTrans опубликовал бенчмарк качества художественного перевода с английского на русский, и прогнал через него больше тридцати моделей – от флагманов OpenAI и Anthropic до китайских новичков.
Перевод – отличный экзамен именно на умение работать с русским текстом. Модель получает английский текст и обязана выдать живой русский: без калек вроде «ты в порядке?», с правильным родом глаголов, с сохранённой грубостью персонажей и рифмой в эпиграфе. И то, что модель показывает на этом экзамене, напрямую переносится на её способность писать и править русские тексты – те самые стихи и документы из моих прошлых статей.
Сто ловушек и судья с ключом
Бенчмарк устроен как школьная контрольная. За основу взят рассказ О. Генри 1906 года, основательно переделанный: действие в наши дни, другие имена, переписанный финал, около 3100 слов. Автор бенчмарка разложил по тексту сто ловушек в двенадцати областях – от точности смысла и идиом до стихов и транслитерации фамилий вроде Cholmondeley («Чамли», а не «Чолмонделей»).
Ловушки недобрые, и это правильно. Врач скорой помощи шесть абзацев упоминается без указания пола, а потом оказывается женщиной – английский позволяет промолчать о поле, а русский переводчик обязан выбрать род глаголов заранее, и не дочитавшие текст модели пишут «сказал доктор Морган». Эту ловушку проваливает больше половины прогонов – даже у флагманов. Слово fair встречается трижды – меткий выстрел, уличная ярмарка, светлый оттенок кожи – и «честный выстрел» пишут три модели из четырёх.
Переводы судит LLM-судья с ключом ответов: по каждой контрольной точке он отвечает «пройдена» или «провалена», а балл считает программа. Это сделано намеренно: свободная «оценка от 0 до 100» плавает между запусками на десятки баллов, а бинарный ответ воспроизводится. Каждый перевод конвейер прогоняет трижды, в отчёт идёт среднее. Текст и ключ спрятаны в запакованном бинарном файле, чтобы ответы не утекли в обучающие выборки.
Что показали модели
Верхушку рейтинга возглавили GPT-6 Astra (90 баллов из ста) и Gemini 3.8 Flash (88). А дальше самое интересное для меня: китайская GLM 5.3 набрала 84 и обошла всех флагманов Anthropic – Claude Fable 5.1 (79) и Opus 5.5 (78,3). DeepSeek V4 Flash с 82,3 обошёл их тоже. Вровень с Opus встали ещё две модели – Kimi K2.7 Code и Hy4.
Профиль GLM по областям красноречивее среднего балла: 11 из 11 за отсутствие калек – единственный чистый ноль среди лидеров – и 14 из 15 за точность смысла. Это модель, которая пишет по-русски, а не переводит с внутреннего английского. Слабое место – точность следования формату: каждый прогон укладывался в требуемый формат ответа только со второй попытки, из-за чего время перевода – 17 минут против 2–4 у западных моделей.
Китайский сегмент при этом огромен по разбросу: от 84 у GLM до 22 у MiMo 2.5 Pro, которая два прогона из трёх не смогла довести перевод до конца. «Китайская модель» – это не марка качества, а лотерея, и рейтинг снимает с этой лотереи крышку.
Есть и общие провалы, не зависящие от места рождения модели. «You look like hell» смягчили до «ужасно выглядишь» все 44 прогона, «Shit» превратили в «Чёрт» – 36, пол врача угадали мужским – 25. Половину этих слабостей можно закрыть промптом, и я писал об этом же в статье про стихи: модель нужно явно учить не стирать грубость и не смягчать регистр.
Результаты GLM совпали с моим собственным опытом. Некоторое время назад я перешёл на GLM с MiniMax M3 ради эксперимента, и с тех пор пишу с ней статьи, письма и стихи. Бенчмарк измерил то, что я вижу каждый день: модель очень хорошо справляется с русским текстом.
Сколько стоит интеллект
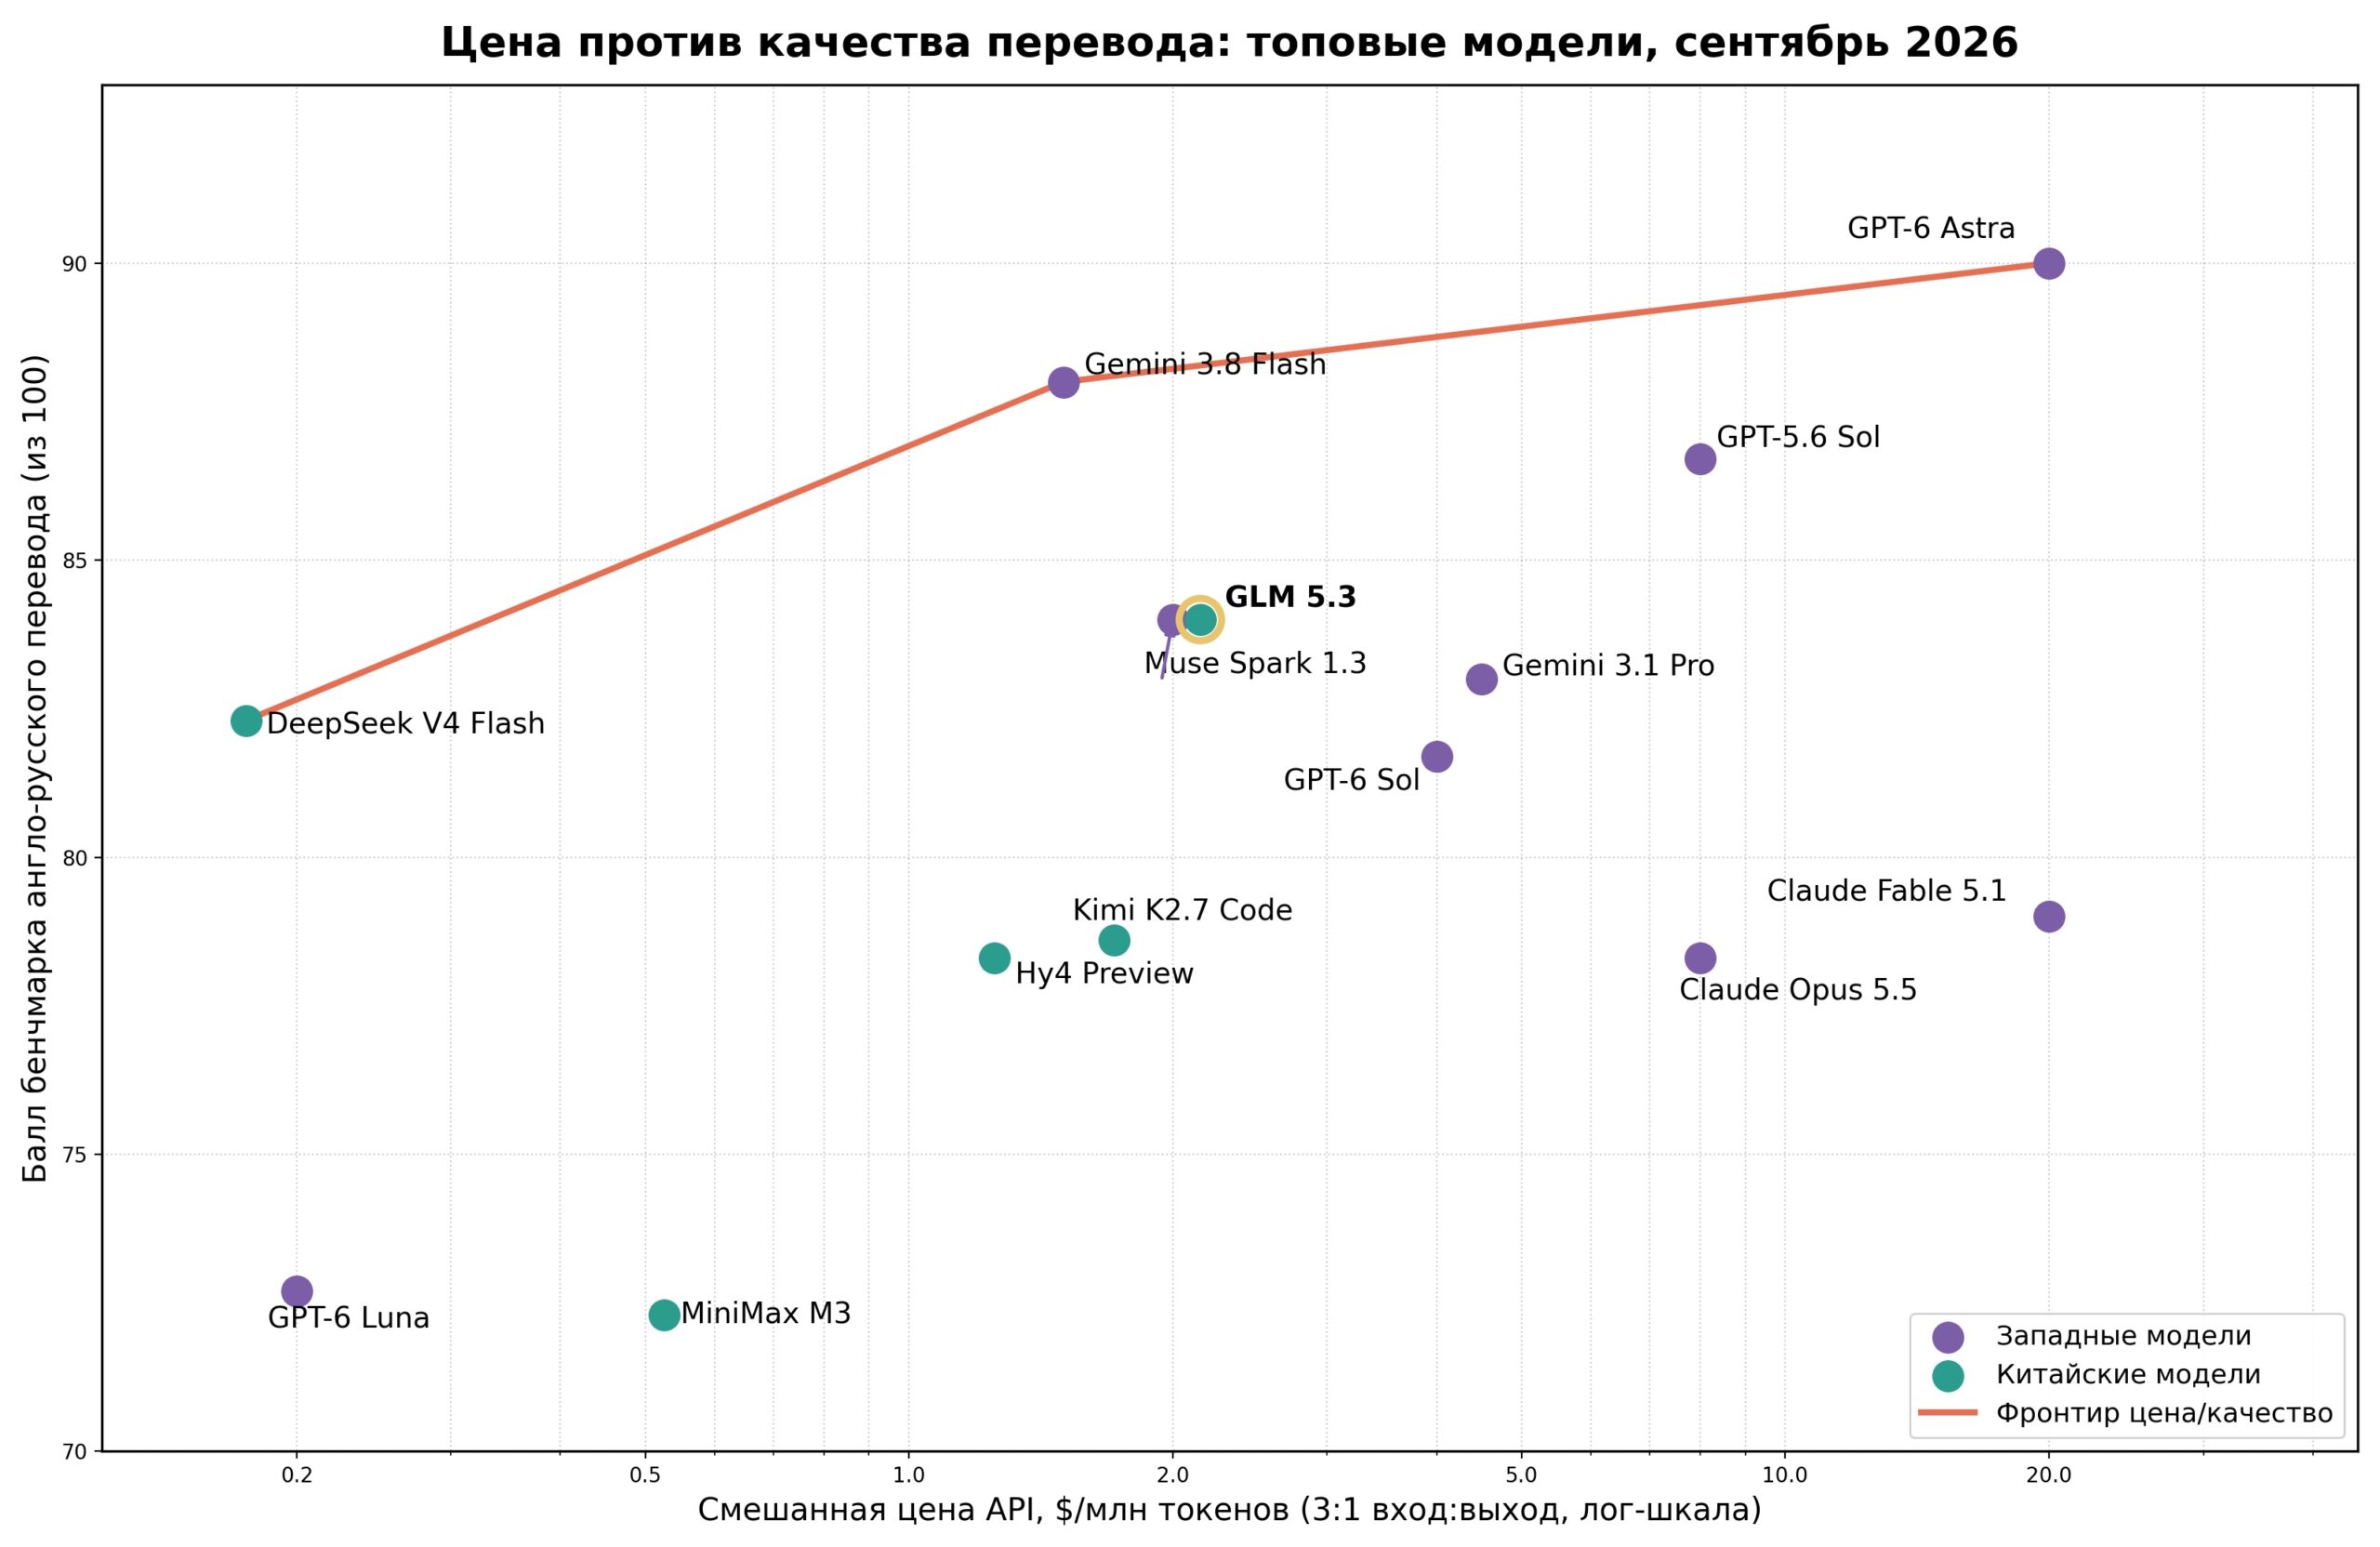
Качество без цены ничего не значит, поэтому я свёл баллы бенчмарка с актуальными ценами API и построил диаграмму: по горизонтали – смешанная цена (три части входа на одну часть выхода), по вертикали – балл.
| Модель | Балл | Вход, $/M | Выход, $/M |
|---|---|---|---|
| GPT-6 Astra | 90 | 10,00 | 50,00 |
| Gemini 3.8 Flash | 88 | 0,75 | 3,75 |
| GPT-5.6 Sol | 86,7 | 4,00 | 20,00 |
| GLM 5.3 | 84 | 1,40 | 4,40 |
| Muse Spark 1.3 | 84 | 1,25 | 4,25 |
| Gemini 3.1 Pro | 83 | 2,00 | 12,00 |
| DeepSeek V4 Flash | 82,3 | 0,14 | 0,28 |
| Kimi K2.7 Code | 78,6 | 0,95 | 4,00 |
| Claude Fable 5.1 | 79 | 10,00 | 50,00 |
| Claude Opus 5.5 | 78,3 | 4,00 | 20,00 |
Картина читается сразу. Идеальный фронтир – DeepSeek V4 Flash, Gemini 3.8 Flash и GPT-6 Astra: за каждый следующий балл придётся платить. Claude из этой картины выпадает целиком: Fable стоит как Astra, но даёт на одиннадцать баллов меньше, Opus за $20 на выход стоит столько же, сколько GPT-5.6 Sol с его 86,7. За деньги Клодов вы перевод не покупаете.
GLM 5.3 держится чуть правее фронтира: за 84 балла – $2,15 смешанной цены против $1,50 у Gemini 3.8 Flash. На рознице разница заметная, но у GLM есть подписка, которая по моим расчётам снижает цену токена в 6–13 раз, и тогда это самый дешёвый способ получить качество выше моделей Anthropic. А для чистовой экономии есть DeepSeek V4 Flash – 82 балла за $0,18 смешанной цены, в десять раз дешевле Gemini.
Что в итоге
Если вы работаете с русскими текстами – пишете, переводите, редактируете – не выбирайте модель по общим бенчмаркам вроде MMLU: они измеряют английский и знания, а не ваш язык. Художественный перевод куда ближе к реальной работе, и теперь он измерен. Измерение подтвердило то, что я и так знал по своей ежедневной работе: лучшие китайские модели уже справляются с русским текстом лучше западных флагманов, и GLM 5.3 – первая среди них. Единственная оговорка – медлительность. Если время не критично, а качество и цена важны – присмотритесь к ней.
Стихи с её помощью уже получаются. Переводческий экзамен она тоже сдала.
Друзья, подписывайтесь на мой Твиттер (там я пишу чаще) и Телеграм, чтобы получать анонсы новых материалов.




Комментариев: 0